Failover czy ponawianie żądań? Sprawdź, co dzieje się po awarii
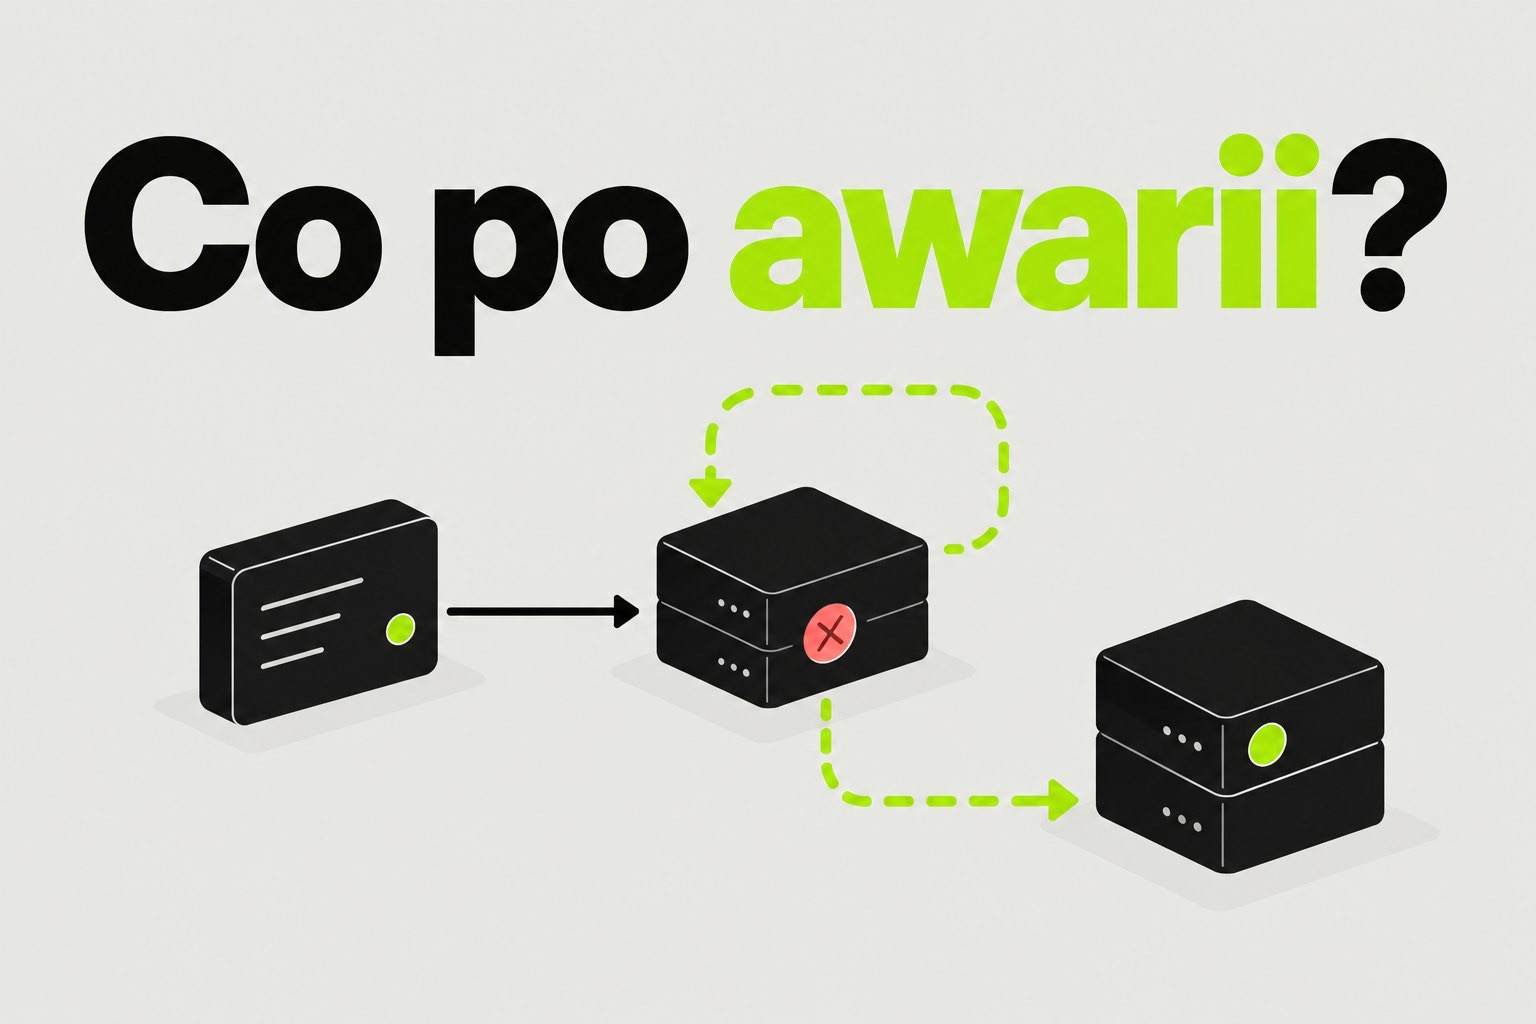
Awaria zależności zaczyna się od pytania
Aplikacja do obsługi zamówień wysyła żądanie do operatora płatności. Nie dostaje odpowiedzi. Próbuje jeszcze raz, potem po raz trzeci. W panelu technicznym widać, że system reaguje na błąd. Klient widzi kręcący się wskaźnik i nie wie, czy zamówienie zostało opłacone.
To dobry moment, by zapytać: co dokładnie robi system po awarii zależności? Czy ponawia tę samą operację, przełącza się na inną drogę, zapisuje zadanie do późniejszego wykonania, czy bezpiecznie informuje użytkownika, że nie może go teraz dokończyć?
Punktem wyjścia jest artykuł opisujący przypadek, w którym mechanizm nazwany failoverem okazał się serią ponowień. Sama liczba prób niewiele mówi o ciągłości działania. Liczy się wynik całego zadania.
Ponowienie i failover rozwiązują różne problemy
Ponowienie żądania ma sens, gdy błąd jest chwilowy: połączenie zostało przerwane, choć usługa zwykle działa poprawnie. Aplikacja wysyła żądanie ponownie i liczy na odpowiedź z tego samego miejsca. Próby powinny mieć limit i mieścić się w czasie, który użytkownik może rozsądnie poczekać.
Failover oznacza zmianę ścieżki po wykryciu problemu. Ruch może trafić do innej instancji, regionu albo dostawcy. W niektórych procesach właściwą ścieżką awaryjną będzie tryb ograniczony: zapisanie zlecenia w kolejce i pokazanie użytkownikowi jasnego statusu. Wybór zależy od tego, co dana operacja musi zakończyć natychmiast, a co może poczekać.
Zapasowa ścieżka musi umieć wykonać potrzebne zadanie i mieć dostęp do odpowiedniego stanu. Sam drugi adres usługi nie wystarczy. Microsoft zaleca sprawdzenie, czy system niezawodnie odróżnia sprawne elementy od niesprawnych i potrafi szybko usunąć te drugie z puli obsługującej ruch.
Policz czas całej operacji, nie jednej próby
Załóżmy, że pojedyncze wywołanie może trwać dwie sekundy, a aplikacja podejmuje trzy próby. Same oczekiwania na odpowiedź mogą zająć sześć sekund. Do tego dochodzą przerwy między próbami oraz czas pozostałych kroków. To przykład obliczeniowy, nie uniwersalne ustawienie: właściwy limit wynika z czasu dostępnego dla całej operacji.
Warto też sprawdzić, kto ponawia żądanie. Jeśli robi to zarówno aplikacja, jak i usługa pośrednia, liczba wywołań rośnie szybciej, niż sugeruje konfiguracja jednego komponentu. Dokumentacja Microsoftu podaje przykład, w którym ponowienia z licznikiem trzy na dwóch poziomach dają łącznie dziewięć prób wobec usługi docelowej.
Gdy zależność jest przeciążona, taki dodatkowy ruch może utrudnić jej powrót do pracy. Google wskazuje przeciążenie jako najczęstszą przyczynę awarii kaskadowych i zauważa, że ponowienia same zwiększają liczbę żądań trafiających do usługi. Dlatego w przeglądzie trzeba policzyć próby na wszystkich poziomach, ustalić wspólny budżet ponowień i określić, po jakich błędach dalsze próby nie mają sensu.
Sprawdź, co stało się z zadaniem użytkownika
Brak odpowiedzi nie zawsze oznacza, że operacja się nie wykonała. Płatność mogła zostać przyjęta, lecz odpowiedź zaginęła po drodze. Ponowienie bez zabezpieczenia grozi drugim obciążeniem albo utworzeniem dwóch zamówień. Przełączenie na dostawcę zapasowego również wymaga ustalenia, co stało się z pierwszą próbą.
Pomaga tu identyfikator operacji, który pozwala rozpoznać ponowne wysłanie tego samego żądania. Tak działa zasada idempotencji: ponowienie nie powinno wywoływać kolejnego skutku. AWS opisuje ten problem na przykładzie operacji tworzenia zasobu: po utracie odpowiedzi klient nie wie, czy pierwsza próba się powiodła, a ponowne wysłanie żądania może stworzyć duplikat.
Dla zespołu produktowego oznacza to konkretne pytania. Czy zamówienie zachowuje swój identyfikator po przełączeniu? Czy system potrafi ustalić status płatności przed kolejną próbą? Czy użytkownik widzi potwierdzenie, stan oczekiwania albo jednoznaczny komunikat o błędzie? Odpowiedź HTTP z zapasowej usługi nie dowodzi jeszcze, że zadanie zostało poprawnie zakończone.
Prześledź awarię krok po kroku
Wybierz jeden ważny proces, na przykład opłacenie zamówienia, zapis wizyty albo wygenerowanie dokumentu. Następnie w środowisku testowym wyłącz lub spowolnij jedną zależność i zapisz przebieg operacji:
- Kiedy system uznaje zależność za niesprawną i co uruchamia tę decyzję?
- Ile prób wykonuje każda warstwa, dokąd je wysyła i jak długo trwa cała operacja?
- Czy zapasowa ścieżka ma potrzebne dane, uprawnienia i wolną pojemność?
- Co dzieje się z operacją, której wyniku nie znamy: czy jest sprawdzana, wznawiana, czy wysyłana od początku?
- Jaki końcowy stan widzi użytkownik i czy zgadza się on ze stanem w systemie?
Samo sprawdzenie, czy proces odpowiada na żądania, może dać zbyt optymistyczny obraz. Microsoft rozróżnia sygnał, że proces żyje, od sygnału, że aplikacja jest gotowa obsługiwać żądania wraz z potrzebnymi zależnościami. Podczas testu warto mierzyć oba, a także czas zakończenia zadania, liczbę ponowień, odsetek przełączeń i przypadki wymagające ręcznej naprawy.
Jeśli awaria trwa dłużej, aplikacja powinna przestać zasypywać niesprawną usługę kolejnymi żądaniami. Mechanizm circuit breaker czasowo wstrzymuje takie wywołania, a później ostrożnie sprawdza, czy zależność wróciła do pracy. Microsoft opisuje, jak połączyć go z ograniczonymi ponowieniami. Trzeba przy tym zdecydować, co aplikacja zrobi w czasie przerwy: użyje alternatywy, odłoży zadanie czy szybko pokaże błąd.
Wniosek
Najlepszy test failoveru zaczyna się od losu zadania, nie od nazwy mechanizmu w konfiguracji. Jeżeli po awarii użytkownik czeka na kolejne próby tej samej operacji, sprawdź, czy istnieje sprawna droga do jej bezpiecznego zakończenia.