Zanim zapiszesz ślad: jakie dane naprawdę są potrzebne do diagnozy?
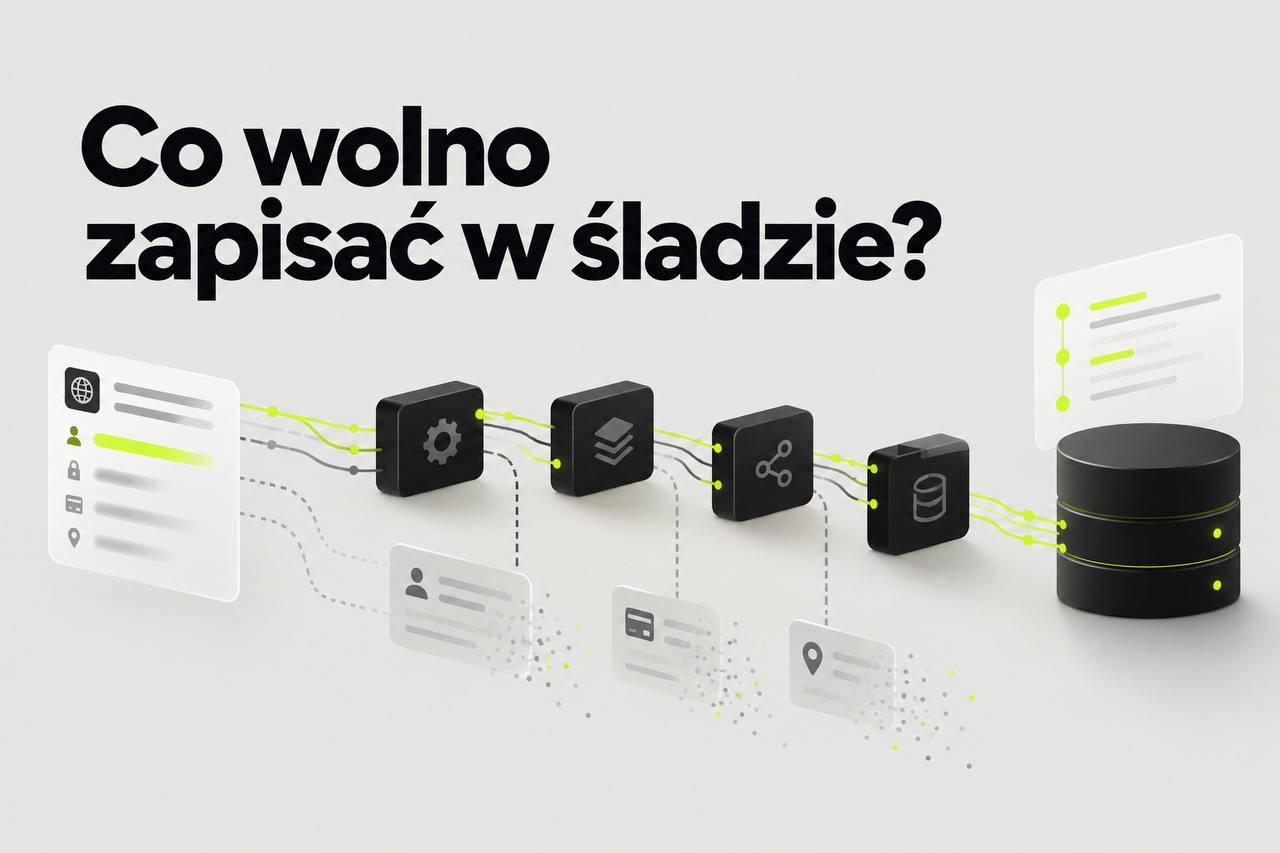
Ślady diagnostyczne pomagają odtworzyć drogę żądania przez aplikację: od kliknięcia w formularz po odpowiedź bazy danych. Kiedy coś zawodzi, zespół widzi, która usługa zwolniła i gdzie pojawił się błąd. Problem zaczyna się wtedy, gdy do śladu trafia również adres e-mail, pełny adres URL z tokenem albo treść zapytania zawierająca dane klienta.
Grafana Tempo 3.1 ułatwia usunięcie takich danych ze składowanych śladów. To dobry moment, by zadać wcześniejsze pytanie: co wolno zapisać, zanim ktokolwiek zacznie te ślady analizować?
Co właściwie zmieniło się w Tempo?
W Tempo 3.0 usunięcie śladów wymagało podania ich identyfikatorów. W wersji 3.1 można wskazać ślady za pomocą zapytania TraceQL, na przykład wybierając te, które mają określoną wartość atrybutu. Można też ograniczyć operację do przedziału czasu. Dzięki temu zespół nie musi ręcznie odnajdywać każdego identyfikatora, gdy ten sam błąd dotknął wielu żądań. Tak opisuje zmianę Grafana.
Słowo „redakcja” łatwo tu źle zrozumieć. W Tempo oznacza ono trwałe usunięcie całych pasujących śladów ze składowiska, a nie zamazanie jednego pola i zachowanie reszty. Dokumentacja polecenia `tempo-cli redact` ostrzega, że operacji nie można cofnąć. Jeśli zapytanie obejmie zbyt wiele danych, znikną również informacje potrzebne do późniejszej diagnozy.
Zapytanie używane do usuwania ma celowo wąską składnię: pojedynczy filtr z porównaniami równości dla atrybutów `resource.` i `span.`, łączonymi przez `&&` lub `||`. To, że bardziej złożone zapytanie działa w Grafana Explore, nie znaczy jeszcze, że nadaje się do redakcji. Tym bardziej nie warto planować ochrony danych wokół obietnicy „w razie czego znajdziemy wszystko później”.
Decyzja zapada przy projektowaniu śladu
Wyobraźmy sobie aplikację do obsługi zamówień. Zespół chce wiedzieć, czy żądanie przeszło przez płatność, ile trwał zapis w bazie i czy odpowiedź zakończyła się błędem. Do tego zwykle wystarczą nazwa usługi, nazwa operacji, wzorzec trasy, czas trwania, kod odpowiedzi i kategoria błędu. Pełny adres e-mail kupującego czy zawartość koszyka nie pomagają ustalić, dlaczego usługa płatności odpowiadała z opóźnieniem.
Praktyczną zasadą jest podział pól na trzy grupy:
- Zapisujemy: atrybuty niezbędne do diagnozy, z jasno określonym zastosowaniem, takie jak nazwa usługi czy kod odpowiedzi.
- Przekształcamy przed wysłaniem: wartości, których struktura jest przydatna, lecz szczegóły są zbędne. Przykładem jest wzorzec `/orders/{id}` zamiast pełnej ścieżki z identyfikatorem zamówienia.
- Nie zapisujemy: haseł, tokenów, danych płatniczych, treści formularzy i innych wartości, dla których zespół nie potrafi wskazać konkretnej potrzeby diagnostycznej.
To nie jest zamknięta lista dla każdej firmy. Warto przejść po własnych punktach wejścia: formularzach, żądaniach HTTP, wywołaniach baz danych, komunikatach kolejek i błędach. Dokumentacja Grafany wymienia duże nagłówki, pełne adresy URL, treści żądań i odpowiedzi oraz pełne zapytania do bazy wśród źródeł rozbudowanych atrybutów, które powstają zwłaszcza przy automatycznej instrumentacji. Takie pola mogą więc zwiększać zarówno ryzyko ujawnienia danych, jak i koszt ich obsługi.
Filtruj przed składowaniem, sprawdzaj na przykładowych żądaniach
Najlepszym miejscem na tę decyzję jest kod instrumentacji albo potok zbierający telemetrię. Konwencje semantyczne OpenTelemetry dla adresów URL zakazują zapisywania w atrybutach danych uwierzytelniających z części adresu z nazwą użytkownika i hasłem, a instrumentacje, które wiedzą, które parametry zapytania są wrażliwe, mają usuwać ich wartości. Dodają przy tym, że oczyszczanie adresów URL powinno być także zadaniem aplikacji i odbiorców telemetrii. W Collectorze procesor redaction może przepuszczać tylko dozwolone atrybuty i maskować wartości pasujące do określonych wzorców. Reguły trzeba jednak sprawdzić na rzeczywistych kształtach żądań: token może pojawić się także w nazwie pola, komunikacie błędu lub niestandardowym nagłówku.
Przegląd warto zrobić razem z osobą, która później będzie diagnozować awarie. Dla każdej dodawanej informacji niech zespół odpowie: „Jaką decyzję podejmiemy dzięki temu polu?”. Jeśli odpowiedź brzmi „może kiedyś się przyda”, lepiej zacząć bez niego. Brakujący bezpieczny atrybut można dodać po testach; raz zapisanej tajnej wartości nie da się potraktować jak zwykłej zmiany konfiguracji.
Gdy dane już wyciekły do śladów
Procedura zaczyna się od zatrzymania źródła: poprawienia instrumentacji lub reguł w potoku. Dopiero potem należy ustalić zakres zdarzenia i przygotować zapytanie do usunięcia śladów. Instrukcja Tempo zaleca sprawdzić wybór w Explore, uruchomić `--dry-run`, poczekać na zakończenie zadań i odczytać liczbę dopasowań z metryki. Sam wynik wyszukiwania w Explore pokazuje próbkę, więc nie wystarcza do oceny skali operacji.
Tempo usuwa ślady z bloków, które były już w składowisku w chwili zgłoszenia zadania. Dane przyjęte później lub jeszcze niezapisane nie są objęte tą operacją; dokumentacja radzi odczekać około 10 minut po zatrzymaniu źródła wycieku, aby bloki zdążyły trafić do składowiska. Trzeba też sprawdzić inne miejsca, do których te same dane mogły trafić, na przykład logi lub eksporty telemetrii. Usunięcie śladu w Tempo nie usuwa jego kopii z innych systemów.
A co z metrykami wyliczanymi ze śladów?
Tempo 3.1 dodaje również eksperymentalną możliwość uwzględniania próbkowania w metrykach TraceQL. Jeśli do Tempo trafia tylko część śladów, zwykłe zliczenie pokazuje ruch widoczny w tej próbce. Grafana podaje przykład: przy próbkowaniu 10% wynik może wynosić około 50 spanów na sekundę, choć rzeczywisty ruch to 500. Wskazówka `with(extrapolate=true)` pozwala oszacować pełny ruch na podstawie prawdopodobieństwa próbkowania zapisanego w spanach; wymaga bloków vParquet4 lub nowszych.
To przydaje się w analizie, lecz nie odzyskuje usuniętych śladów i nie rozwiązuje problemu wrażliwych atrybutów. Próbkowanie odpowiada na pytanie, ile danych analizować. Zasady zapisu odpowiadają na pytanie, jakie dane w ogóle mogą znaleźć się w systemie.
Wniosek
Ochronę danych w śladach projektuje się przed ich wysłaniem. Tempo 3.1 daje zespołowi skuteczniejsze narzędzie do usuwania skutków pomyłki, ale najwięcej spokoju daje krótka, uzgodniona lista atrybutów potrzebnych do diagnozy — i konsekwentne odrzucanie reszty.